ハードウェアエンコードによるリソースダッシュボード
amdva-dashboard はローカルの AMD APU の計測値を取得し、承認済みのダッシュボードの構成 を GPU サーフェス上に描画して、H.264 を RTSP で配信します。ブラウザー、デスクトップセッション、Qt、モデル、推論エンジンはいずれも不要です。HTML は合成データによる見た目のプロトタイプのままで、ネイティブのサーバーは実際の計測値を使い、DEMO バッジを表示しません。
ビルドと起動
通常のロック済みブートストラップでは、ダッシュボードが既定でビルドされます。追加のフォントパッケージと DRM パッケージは .deps 以下にインストールされ、システムのパッケージは変更されません。
python3 scripts/bootstrap.py
source scripts/env.sh
build/examples/resource-dashboard/amdva-dashboard --power-max-w 48
サーバーはすべての IPv4 インターフェースのポート 8554、マウント /dashboard で待ち受けます。別の PC からは rtsp://<server-IP>:8554/dashboard で接続してください。このサンプルは認証のない RTSP を提供し、認証や TLS の層は追加しません。この PC 内だけで使う場合は、--bind 127.0.0.1 を指定してください。
依存関係を用意したあとで、ダッシュボードだけをビルドするには次のようにします。
source scripts/env.sh
cmake -S . -B build-dashboard \
  -DAMDVA_BUILD_NVR=OFF -DAMDVA_BUILD_PLUGINS=OFF \
  -DAMDVA_BUILD_STREAMING=OFF -DAMDVA_ROCM_ROOT="$AMDVA_ROCM_ROOT"
cmake --build build-dashboard -j6
build-dashboard/examples/resource-dashboard/amdva-dashboard --power-max-w 48
AMDVA_BUILD_DASHBOARD=OFF を指定するとこのサンプルを除外します。再利用可能な amdva_monitor
ライブラリは、これとは独立してビルドおよびインストールされます。既存のランタイムには引き続きリポジトリの HIP/libva 依存関係が必要です。ダッシュボードは HIP による推論を行わず、Qt にも MIGraphX にもリンクしません。
| オプション | 既定値 | 意味 |
|---|---|---|
--bind |
0.0.0.0 |
待ち受けアドレス |
--port |
8554 |
RTSP ポート(1–65535) |
--mount |
/dashboard |
RTSP マウントの絶対パス |
--render-node |
/dev/dri/renderD128 |
計測、GL、VA に使う AMD DRM レンダーデバイス |
--fps |
10 |
出力フレームレート(整数、1–60) |
--bitrate-kbps |
4000 |
エンコーダーの目標ビットレート(kbps) |
--power-max-w |
48 |
Power バーのスケール(ワット単位、正の有限値) |
--font |
自動 | フォントファイル。AMDVA_ROOT が設定されていればローカルのロック済み DejaVu Sans Bold を優先し、次に Fontconfig を使います |
--duration-seconds |
無制限 | 指定時間後に終了する任意設定。テストに便利です |
--cpu-name、--gpu-name |
自動検出 | /proc/cpuinfo の CPU 名と libdrm の GPU の製品名の代わりに表示する文字列。表示できる ASCII 文字で 120 文字まで |
解像度は 1920 × 1080、プログレッシブ、NV12、BT.709 リミテッドレンジです。H.264 には
B フレームがなく、キーフレーム間隔は最大 1 秒です。音声はありません。不正なコマンドライン値は拒否されます。--help は GPU の初期化を必要としません。Power のスケールは表示だけを変更し、マシンの電力制限は変更しません。スケールを超える実際の計測値も、バーを上限まで振り切った状態で表示されます。
受信と NVR との連携
両方をこの PC で実行する場合は、NVR の Cameras ページで URL
rtsp://127.0.0.1:8554/dashboard のカメラを追加し、Live で選択します。ほかの登録済みソースと同じように録画され、Recordings でハードウェア再生できます。ダッシュボード自体は AI に依存しませんが、選択したチャンネルには NVR で設定した AI
ポリシーも適用されます。
ストリームを単独で確認するには、たとえば FFmpeg がインストールされていれば次のようにします。
ffplay -rtsp_transport tcp rtsp://127.0.0.1:8554/dashboard
ffmpeg -rtsp_transport tcp -i rtsp://127.0.0.1:8554/dashboard \
  -t 30 -c copy dashboard.mkv
複数の RTSP クライアントは同じエンコーダーとリソース履歴を共有します。最後のクライアントが切断するとフレーム生成は止まりますが、計測は続き、新しいクライアントは新しいメディアセッションを開始できます。appsrc、生フレームのキュー、VA プールはいずれも上限付きです。処理が飽和した場合は、フレームの滞留を無制限に保持せず描画処理を省きます。PTS/DTS は各メディアセッションの単調増加クロックに基づき、取りこぼしたフレーム間隔の分をまとめて送出して追いつくことはしません。
GPU サーフェスの経路
/proc + amdgpu sysfs -> ResourceMonitor -> bounded history / drawing geometry
                                                    |
                         EGL/GLES FBO -> shared BGRA VA surface
                                                    |
                              VA VideoProc -> NV12 VAMemory pool
                                                    |
                         appsrc -> vah264enc -> h264parse -> RTP -> RTSP
EGL デバイスは、VA と同じ DRM レンダーノードで選択します。書き込み可能な DMA-BUF のエクスポートをフレームバッファーのアタッチメントとしてインポートします。VA での変換の前に GL フェンスで描画を完了させ、エンコーダーへの投入の前に VA の同期で NV12 の書き込みを完了させます。エンコーダーがフレームを保持している間は、バッファーの所有権によってプールでの再利用を防ぎます。エンコーダーの sink は、投入された VA サーフェスの識別情報と共有ディスプレイを検証します。ロック済みの VA エンコーダーは入力 caps だけからは VUI フィールドを出力しないため、圧縮済みのエンコーダー出力に対して範囲を限定した SPS の書き換えを行い、BT.709 の色度座標(primaries)、伝達特性、行列係数、リミテッドレンジを明示的に通知します。スライスデータとタイミングはそのまま保たれます。これは圧縮ヘッダーの処理であり、生画像の転送ではありません。
フレーム画像を CPU にマップ、ダウンロード、アップロードすることはありません。フォントのグリフは起動時に一度だけラスタライズしてアップロードし、その後に CPU からアップロードするのは映像の画素ではなく図形の座標データです。エンコード済みのビットストリームのバッファーは、RTP やネットワーク送信のために CPU で扱います。これは生画像を GPU 上に置いたまま処理する経路であり、圧縮済みのネットワークデータが CPU を一切通らないという意味ではありません。ソフトウェアレンダリングやソフトウェアエンコードへのフォールバックは提供しません。必要な EGL/VA の処理が失敗するとサーバーは停止します。
検証済みの Radeon 890M / Mesa 25.2.8 では、VPE は出力フォーマットとしての NV12 を受け付けません。そのため VA VideoProc は、この RGB から NV12 への変換を GPU コンポジター経由で行います。この場合も CPU での画素転送はありません。これは、NVR がサポートする NV12 から BGRA への VPE スケーリングとは逆方向です。そのため、観測可能な VPE クライアントがほかにない場合、VPE の使用率は取得できないままになることがあります。
Mesa 25.2.8 は、最初の 16 フレームのあと、同一領域のフォーマット変換をエンコーダー側に先送りします。これにより VA の処理が失敗し、可変な RGB ソースが保持されたままになる可能性があります。レンダラーは 1920 × 1082 の BGRA 領域を確保して 2–1081 行目に描画し、その矩形を原点 0 の 1920 × 1080 NV12 に明示的に変換します。変換元と変換先の原点を変えることで、ダッシュボードの内容を切り取ったり CPU コピーを追加したりせずに、この EFC の近道を回避します。関連する Mesa のソース: 後処理、ピクチャーの投入。
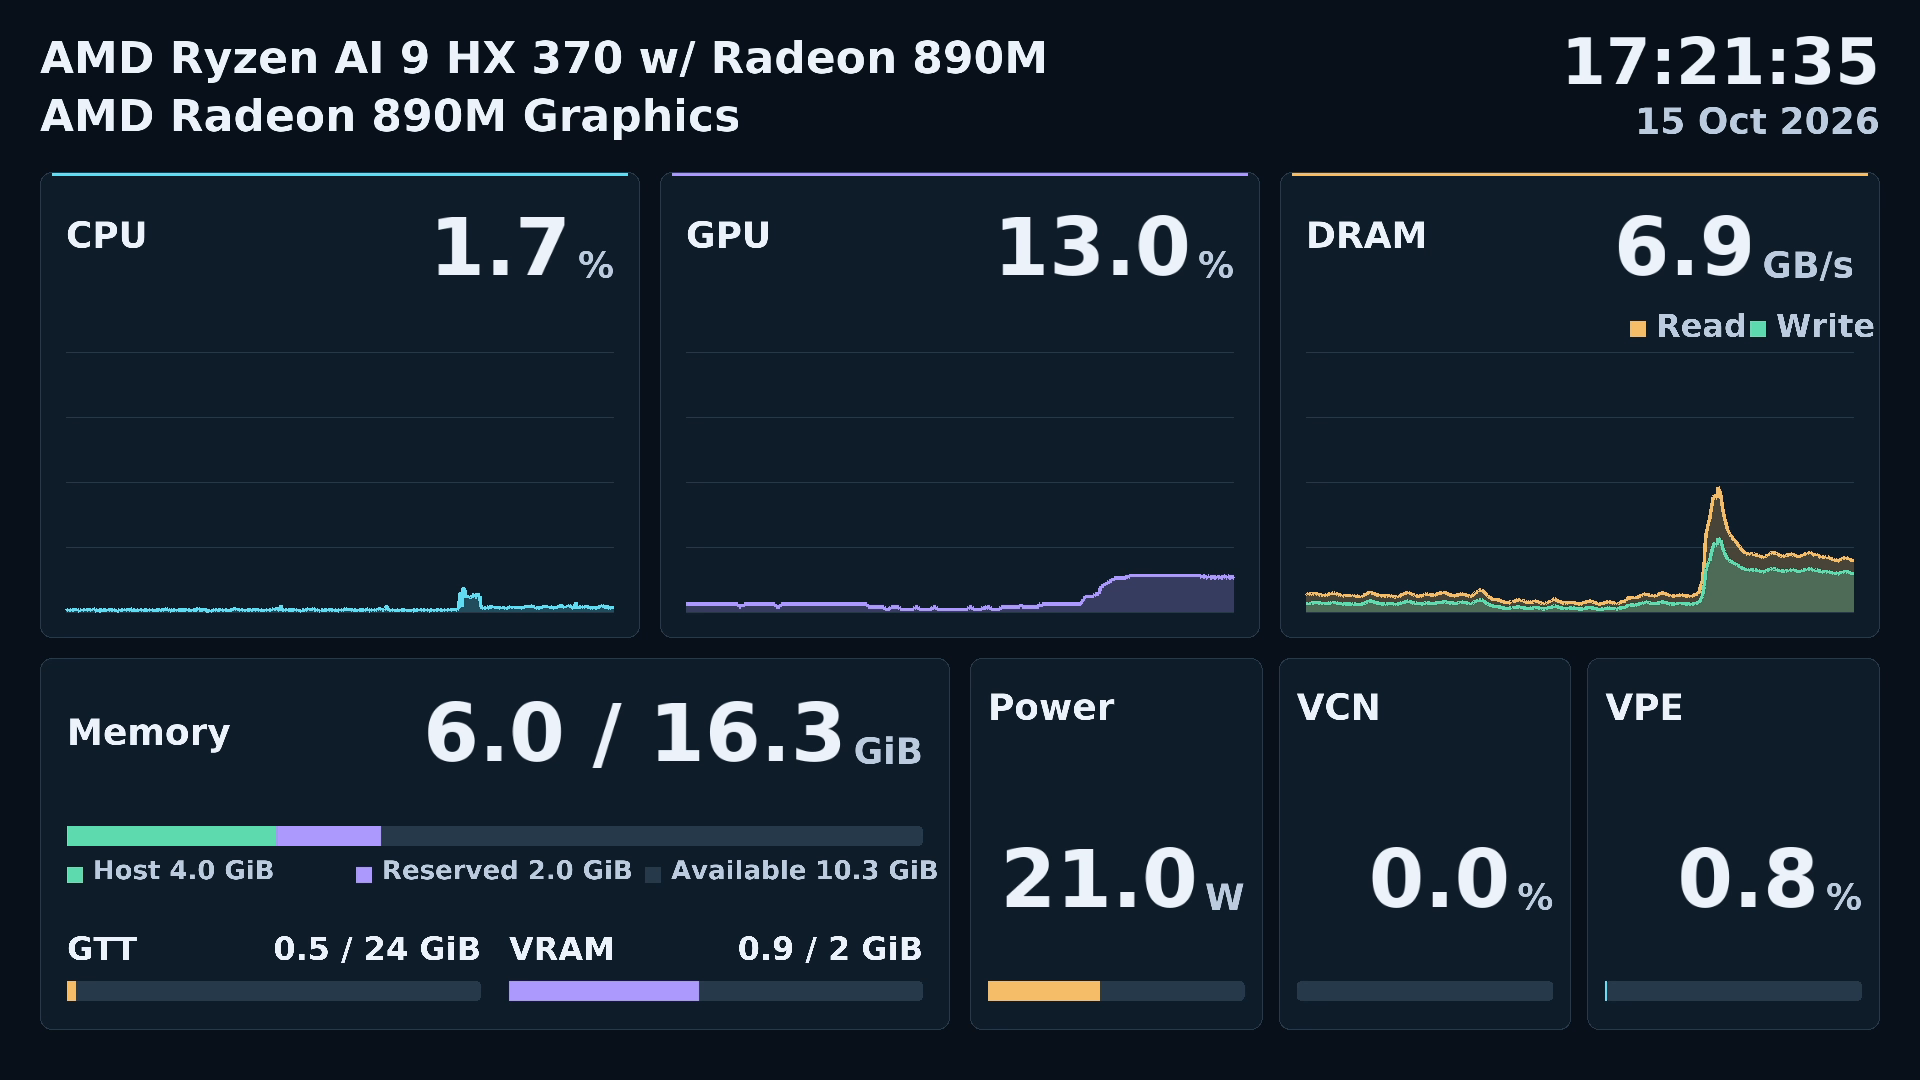
計測の仕様
Qt に依存しない公開ヘッダー amdva/resource_monitor.hpp は、ResourceMonitor、ResourceMonitorConfig、ResourceSample を提供します。sample() は同期型で、単一の呼び出し元から使う API です。単調増加のナノ秒と実時間のミリ秒を返します。各メトリクスはすべて省略可能で、値がない場合は、非対応、アクセス不可、不正、またはまだ計測できないことを表します。プロセス終了時に procfs の読み取りが失敗しても、モニターを終了させずに欠損データとして扱います。これは映像の遅延テレメトリとは別のものです。
サンプリングは通常 100 ms ごとに行います。履歴は最大 601 サンプル、60 秒分を保持します。ハードウェア SMU の平均値には、約 1 秒のフィルタリングがかかっている場合があります。起動時に架空の履歴を生成することはありません。データの欠損やサンプル間隔の大きな空きがあると、グラフの線と塗りつぶしは途切れます。デバイス名は起動時に検出し、日時はホストのローカルタイムゾーンで表示します。
| 計測値 | 取得元と解釈 |
|---|---|
| CPU | /proc/stat の差分。システム全体で 0–100%。最初のサンプルは値なし |
| GPU | 任意のdevice counterによるwave存在率。有効なサンプルがなければ gpu_busy_percent |
| VCN | 優先: 読み取り可能な DRM クライアントのビジー時間の差分から求めた、最も負荷の高いエンコード/デコードのエンジンクラス(enc、dec、enc_1)。対になる DRM カウンターがない場合は vcn_busy_percent にフォールバック |
| Host memory | /proc/meminfo の合計、および合計から利用可能量を引いた値 |
| VRAM reservation / used | mem_info_vram_total / mem_info_vram_used |
| GTT used / limit | mem_info_gtt_used / mem_info_gtt_total |
| DRAM read / write | 検証済みのリトルエンディアン gpu_metrics v3.0 の読み出し/書き込み帯域。MB/s から 10 進の GB/s に換算 |
| Socket power | 同じ v3.0 のデータ。mW を W に換算 |
| VPE | 選択した PCI デバイス上の読み取り可能な /proc/PID/fdinfo クライアントのビジー時間の差分。デバイス/クライアント ID で重複を除き、エンジン容量で正規化 |
v3.0 のパーサーはリビジョン、宣言されたサイズ、実際に読めるバイト数を検証し、「利用不可」を示す番兵値は値なしとして扱います。ほかのリビジョンから値を推測して作ることはなく、独立した sysfs の計測値は引き続き取得します。root 権限やシステムの調整は不要です。DRM に基づく VCN と VPE の値は読み取り可能なクライアントを対象とし、システム全体を網羅する保証はありません。各クラスは報告されたエンジン容量(既定は 1)で正規化します。別名は PCI デバイス、クライアント ID、エンジンクラスで重複を除き、選択したデバイス上の独立したクライアントは合算します。単一の VCN 値はこれらのクラス別割合の合計ではなく最大値です。エンコードとデコードのエンジンは別々に同時に動作できるためです。JPEG は含みません。これはビジー時間による推定値であり、コーデックのピークスループットに対する割合ではありません。VCN4 では、エンコードとデコードの統合キューは
NVR のデコードも含めて enc として計上されます。
検証済みの Radeon 890M では、ハードウェアでエンコードとデコードを実行している間も
vcn_busy_percent は 0 のままですが、DRM カウンターは増加します。そのため、対になる
DRM の計測値を、計測された 0 も含めて優先します。最初の観測時、カウンターの欠損時、カウンターの後退時には
DRM の差分が得られないため、VCN は有効な sysfs データにフォールバックし、VPE は取得できないままになります。カウンターが後退した場合は、カウンターが追いつくまで最高値を保持します。終了したクライアントは破棄します。カーネルの DRM 統計の仕様、amdgpu のエンジン名、VCN4 の統合キューの実装を参照してください。
メモリは 2 進の GiB で表します。メインの合計は Host の容量に専用の VRAM 予約領域を加えたもので、分子は Host の使用量にその予約領域全体を加えたものです。GTT は重ねて加算することも、Host から差し引くこともしません。下段の個別のバーでは、GTT をそれ自身の上限に対して、VRAM の使用量をその予約領域に対して表示します。これは管理対象の領域を表し、物理的に搭載されたすべての RAM を表すものではありません。たとえば検証用 PC は mem=16G で起動しており、表示される検出容量は 2 GiB の予約領域を含めて約 16.3 GiB です。HTML の模擬データの 32 GiB ではありません。起動設定は変更しません。共通の計上方法の根拠と元の参照リポジトリについては、プロトタイプの定義を参照してください。
wave存在率の任意収集
AMDVA_GPU_WAVE_MODE=continuous を指定すると、独立した amdva-wave-sampler プロセスで収集します。
window は500 ms収集して500 ms休止し、sysfs は収集を無効にします。
クロックが変動する試験で候補値と実時間の稼働率に差が残ったため、既定は sysfs のままです。
詳細は後述の受入結果を参照してください。
ホストにROCprofiler-SDKのヘッダーとライブラリがあればヘルパーをビルドします(AMDVA_BUILD_WAVE_SAMPLER=OFF で省略)。
対象はUbuntu 26.04/gfx1151に限定し、他の構成では画面のGPUラベルを変えずに従来値を使います。
scripts/env.sh を読み込んだあと、AMDVA_GPU_WAVE_MODE=window build/examples/resource-dashboard/amdva-dashboard で診断用の候補値を明示的に選択できます。
候補式は、同一収集区間の 100 * mean(SQ_BUSY_CYCLES) / GRBM_COUNT です。
領域数はSDKから取得します。
メモリ待ちを含むwave常駐中のサイクルを数えるため、ALU命令の発行率や追加処理の余力は表しません。
クロックの正規化とpower gatingの影響も実機受入で確認します。
ResourceMonitorConfig::wave_sample_path で、原子的に更新するサンプルファイルを指定できます。
監視API自体はスレッドやプロセスを起動しません。
ファイルにはPCI識別子、起動識別子、単調時計による収集完了時刻、生のカウンター値を含めます。
更新から3秒を超えた値、識別子の不一致、分母0、不完全な値、範囲外の値は採用せず、sysfsへ戻します。
既存の gpu_pct と画面ラベルは維持します。
取得方式と状態は ResourceSample::gpu_source、gpu_status およびダッシュボードのログで確認できます。
ダッシュボードは /run/user/UID/amdva-wave のユーザー専用ディレクトリとGPU単位のロックを使ってヘルパーを管理します。
SDKの初期化失敗、バイナリーの欠損、収集プロセスの終了時も、描画を継続して従来値を使います。
NVRへのprofiler注入やハードウェアキュー数の変更は行いません。
検証
VCN カウンターの不具合修正の確認(2026-10-15): 既存のダッシュボードのエンコーダーと
NVR のデコーダーが動作している間、sysfs は 0% を報告しましたが、修正後のモニターは
1 秒間隔 5 回で 8.7–9.1% を計測しました。ポート 8596 で 20 秒間実行した独立のヘッドレスサーバーに対して
12 秒間の RTSP 録画を行ったところ、追加のエンコード負荷の間は 13.6–13.8% を報告し、投入フレームは 124、スキップしたフレームは 0、コピー監査のエラーは 0 でした。録画には H.264 1920×1080 BT.709 リミテッドレンジのフレームが 121 個含まれていました。ダッシュボード単体の CTest 契約テスト 8 件はすべて合格しました。これには、VCN のカウンター、容量、別名、複数クライアント、PCI フィルター、アイドル、フォールバック、カウンターの後退、不正な入力に関する新しいケースが含まれます。ローカルの成果物: artifacts/dashboard-vcn-live.log
と artifacts/dashboard-vcn-rtsp/。これらの観測結果から、この負荷でビジー時間が報告されることは分かりますが、コーデックのピークスループットの較正にはなりません。
ビルド後、未使用の出力ディレクトリを指定して、実際の RTSP シナリオを実行します。
source scripts/env.sh
python3 examples/resource-dashboard/validate.py --seconds 600 --output artifacts/dashboard-check
このツールは DISPLAY/Wayland なしでサーバーを起動し、コピー/GL 画像の監査を有効にして、複数のクライアントで同時に受信します。全クライアントの切断と再接続を試し、2 つ目のクライアントを強制終了し、録画した H.264 ファイルを検証します。デコードした診断用の画像は受信側プロセスでのみ取得します。240 秒のウォームアップ後は、既存の 64 MiB の RSS/GPU 増加と 44 FD の増加に対する上限チェックが適用されます。FPS とリソース使用量は観測値であり、運用時の性能評価ではありません。
resource-monitor-contract は、メトリクスの ABI/単位/番兵値、欠損データ、CPU の差分、メモリ容量、重複した DRM FD、最初のサンプル、クライアントとカウンターのライフサイクルを対象とします。CLI のテストでは、ヘルプと不正な設定を確認します。SPS の契約テストでは、色情報の通知、ジオメトリとタイミングの保持、SPS 以外の NAL が変更されないこと、不正なデータを確認します。コピー監査の契約テストでは、オプトインの GL リードバック検出も確認します。既存の NVR の診断用キャプチャーでは GL の監査を無効にしたままにしています。ダッシュボードは起動時のフォントのアップロード後に監査を有効にします。
NVR をビルドした場合、amdva-dashboard-nvr-validate CONFIG.json は、選択した単一のダッシュボードソースを対象とする手動テスト用の補助ツールです。ライブのデコード、描画と AI、カタログへの録画、ハードウェア再生を検証します。設定と録画のルートは別に用意し、セグメントは 5 秒にしてください。インストールされた本番用サーバーは、この補助ツールにも Qt にも依存しません。
Ubuntu 26.04/gfx1151でのwaveカウンター受入
2026-11-12の記録には、micro試験24件、外部収集プロセスによるGUI試験4件、組み込みによるGUI試験8件(continuousとwindow)を保存しています。 各GUI試験は60秒以上実行し、集計では冒頭20秒を除外しました。 保存済みの選択設定では映像15本とダッシュボードを表示し、映像16本とダッシュボードを録画します。 cam15はデコードや解析の対象にしていません。 次の増減率は、各条件群の収集なしの中央値を基準にしています。
| 項目 | 外部の連続収集 | 組み込みの連続収集 | 組み込みのwindow収集 |
|---|---|---|---|
| 描画FPS | +0.09% | -0.24% | +0.18% |
| 実効AI Hz | +0.12% | -1.32% | -1.30% |
| YOLO推論P95 | +0.53% | +6.71% | -2.31% |
| ReID推論と転送P95 | -3.02% | +10.30% | -0.15% |
外部収集プロセスによる比較では、観測値が性能の採用基準内に収まりました。 組み込みの連続収集では、YOLO推論とReID推論および転送のP95が5%の許容値を超えました。 window方式は観測値が性能基準内に収まり、処理P95の最大増加は3.30%、実効AI頻度の低下は1.30%でした。 少数回の比較には基準値の変動が含まれるため、差の因果関係や「性能影響ゼロ」を示す結果とは扱いません。 P95はアプリケーションが報告する移動集計の要約であり、全処理時間を合わせて算出した百分位数ではありません。
自動採用は保留しました。
休止を挟む負荷の実時間の稼働率は25.41%でしたが、対応する収集区間の候補値は平均23.13%でした。
稼働区間にはkernel投入と完了待ちの時間も含むため、WGPの実時間による存在率を直接測った値ではありません。
この比較では正規化の妥当性を確認できませんでした。
1 streamの試験では、断続的に処理していても GRBM_COUNT が0になりました。
既定はsysfsを維持し、候補値はサイクルに基づくwave存在率として明示指定による診断に使える形にしました。
取得できない区間はsysfsへ戻します。
空streamの候補値は0%、FMA負荷は約98.7%、依存するメモリー読み出しの負荷は約96.7%でした。
ヘルパーの重複起動、終了、バイナリー欠損、SDK初期化失敗も確認しました。
各GUI試験の全17ソースについて録画カタログとコーデック情報を検査し、copy audit違反はありませんでした。
契約テスト30件も通過しました。
生ログ、スクリプト、録画は /home/amd/work/rai/logs/gpu-counter-overhead-20261112 に保存しています。
記録済みの結果
検証記録には、実装のリビジョン、固定したランタイムとの差異、ハッシュ、ローカルの成果物が記録されています。CTest の 23 ケースはすべて合格しました。600 秒間のヘッドレス実行では、クライアントの共有、全クライアントの切断/アイドル/再接続、クライアントの突然の切断に合格し、3 つの録画はいずれも 10fps の有効な 1080p H.264 でした。ウォームアップ後の最大増加量は RSS が 68 KiB、GPU 割り当てが 0、FD が 3 で、既存の上限内でした。コピー監査の違反はありませんでした。
最終的な実装は、別途行った 110 秒間の RTSP 回帰テストと、30fps/65W での LAN 待ち受けテストに合格しました。後者では 50 秒間に 1,501 フレームを録画し、BT.709 の色度座標/伝達特性/行列係数とリミテッドレンジが確認できました。NVR のライブ描画、AI、録画の検索、ハードウェア再生に合格し、NVR のフラグメントはすべて確定してメディア検査に合格しました。クライアント接続中の時間指定によるサーバー終了は、GStreamer の critical を出さずに完了しました。ダッシュボード単体のビルドは Qt にも MIGraphX にもリンクせず、インストールした CMake SDK のクライアントは AMDVA::amdva_monitor を問題なく使用できました。
DRAM の履歴は積み上げ表示です。琥珀色の Read が 0 から始まり、緑の Write がその上に重なります。上端は Read + Write を表し、GB/s の数値と一致します。縦軸のスケールは表示中の履歴での合計のピークに合わせます(20 GB/s 単位、最小 20 GB/s)。読み出しまたは書き込みのサンプルが欠けている場合は、両方の領域が途切れます。